NewsLetter #33
AI nella PA. L’equità comincia dal dato
Nella parte relativa ai dati la Community scrive che "la raccolta è una fase politica" e affida ai Comitati Unici di Garanzia il compito di accorgersene per primi
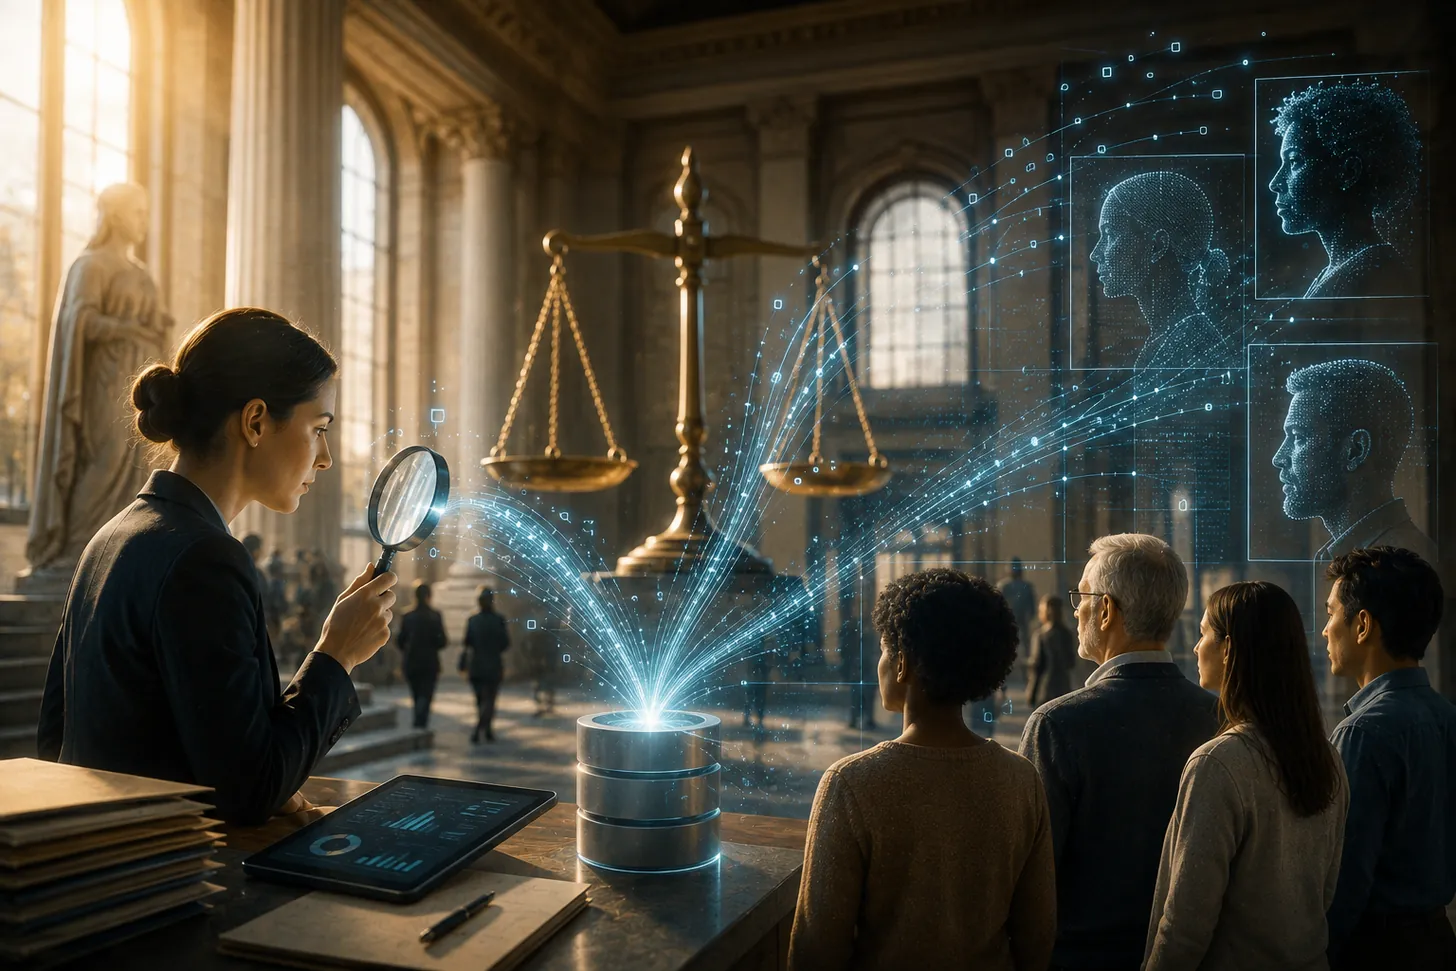
ChatGPT: “Equità inizia dal dato”
In breve, per chi ha poco tempo
⚖️ La definizione che conta. Equità algoritmica come capacità di progettare, addestrare, utilizzare e monitorare sistemi orientati a ridurre le discriminazioni esistenti: una proprietà del processo, verificabile in ogni fase.
🗳️ La frase chiave. La raccolta dei dati va riconosciuta come fase politica oltre che tecnica, poiché condiziona l’equità futura dei sistemi.
🗂️ Il linguaggio dentro i dati. Categorie, classificazioni e narrazioni dominanti si depositano nei dataset e vengono riprodotte dai modelli: materia di comunicazione, prima che di informatica.
🛡️ Chi controlla. Il documento propone di impiegare i Comitati Unici di Garanzia come rilevatori precoci degli effetti discriminatori, senza istituire nuovi organismi.
Il blocco più denso delle Raccomandazioni della Community italiana per il governo aperto sull’utilizzo dell’Intelligenza Artificiale riguarda i dati e occupa tre delle dodici voci. Si apre con una definizione che sposta un concetto spesso usato in modo vago verso un terreno operativo. Per equità algoritmica il documento intende la capacità di progettare, addestrare, utilizzare e monitorare sistemi orientati alla riduzione delle discriminazioni esistenti, e di verificare che non ne producano di ulteriori su persone e gruppi sociali, in particolare quando questi effetti derivano da dati incompleti, sbilanciati, non aggiornati o non adeguatamente documentati.
Quattro verbi in sequenza, progettare, addestrare, utilizzare, monitorare, bastano a chiarire che l’equità viene trattata come proprietà del processo, verificabile in ogni sua fase. Segue l’affermazione più politica del testo: la raccolta dei dati dovrebbe essere riconosciuta come fase politica oltre che tecnica, poiché condiziona la futura equità dei sistemi. Chi decide quali dati raccogliere, con quali categorie e con quale grana, compie una scelta che produrrà effetti sui diritti anni dopo, quando quei dati alimenteranno un modello.
Una catena di custodia per il dato pubblico
La seconda raccomandazione traduce il principio in richieste puntuali. I dati utilizzati per addestrare, validare e alimentare i sistemi dovrebbero essere valutati, aggiornati, tracciabili, accurati, pertinenti e, ove possibile, disaggregati. I dataset dovrebbero essere corredati da metadati chiari su provenienza, limiti, modalità di raccolta, finalità e contesto d’uso, resi disponibili anche a chi svolge ricerca indipendente. Dovrebbero essere sottoposti a processi continui di pulizia, riequilibrio, controllo e auditing, con indicatori misurabili di qualità: completezza, accuratezza, aggiornamento, rappresentatività, copertura territoriale. La disaggregazione per categorie rilevanti, come genere, età, territorio o condizione socio-economica, viene indicata come condizione essenziale per individuare pregiudizi e verificare l’impatto sui diversi gruppi.
L’insieme descrive una catena di custodia paragonabile a quella che il diritto conosce per le prove: si sa da dove viene il dato, chi lo ha maneggiato, che cosa gli è stato fatto e con quale scopo. Per un’amministrazione che debba difendere in giudizio un provvedimento istruito con il supporto di un sistema automatico, questa documentazione è l’unica capace di sostenere la motivazione dell’atto. Il tema esce così dall’area informatica ed entra nella responsabilità dirigenziale.
Un esempio rende concreta la questione della disaggregazione. Un ente che addestri un sistema di smistamento delle istanze sulla serie storica delle pratiche ricevute allo sportello fisico costruisce un modello che rappresenta la popolazione capace di raggiungere lo sportello negli orari di apertura. Chi lavora su turni, chi vive nelle frazioni servite male dal trasporto pubblico e chi delega a un patronato entrano nella base informativa con pesi diversi da quelli reali. La disaggregazione per territorio e per condizione socio-economica serve a rendere visibile lo scarto prima che diventi una regola implicita del servizio, e la copertura territoriale è il parametro che lo intercetta con il minor costo di rilevazione.
Le parole si depositano nei dati
La terza raccomandazione affronta la qualità etica e sociale dei dati e parte da una constatazione asciutta: i dati non sono mai completamente neutri, poiché riflettono modalità di raccolta, classificazioni, linguaggi, norme culturali, fonti disponibili e narrazioni sociali dominanti, ricorrenti, omologanti o marginalizzanti. Il documento chiede alle amministrazioni una valutazione etico-sociale dei dataset che analizzi il linguaggio, le categorie utilizzate, le rappresentazioni implicite, le fonti originali e le narrazioni presenti nei dati, comprese quelle che rischiano di essere riprodotte dai sistemi.
Per chi lavora sulla lingua delle istituzioni questo è il passaggio più interessante del documento. La riproduzione delle narrazioni dominanti dentro i sistemi automatici avviene attraverso il vocabolario con cui i fenomeni sono stati registrati: le categorie di una banca dati sono decisioni linguistiche prima che informatiche, e ogni decisione linguistica seleziona ciò che diventa visibile. Un ufficio che classifica le segnalazioni dei cittadini con una tassonomia costruita vent’anni fa consegnerà al modello la fotografia di una città che non esiste più. La manutenzione del lessico amministrativo, che molte redazioni istituzionali svolgono da tempo con pochi mezzi, acquista qui una funzione tecnica misurabile.
Il testo chiede inoltre checklist di conformità, criteri documentati e indicatori replicabili, per evitare che la valutazione etica resti affidata a giudizi soggettivi; team multidisciplinari con competenze tecniche, giuridiche, sociali, comunicative, etiche e organizzative; un monitoraggio continuo degli output, documentato e supportato da interventi umani che funzionino come early detectors delle distorsioni, anche con l’ausilio dei Comitati Unici di Garanzia. Il richiamo ai CUG è concreto e poco citato: sono organismi già presenti in ogni amministrazione, con competenze su pari opportunità e benessere organizzativo, e il documento propone di impiegarli come sentinelle sugli effetti discriminatori dei sistemi. Una funzione nuova affidata a una struttura che esiste già, senza costi di istituzione.
Privacy e valutazione etica non coincidono
La valutazione etico-sociale va tenuta distinta dalla valutazione d’impatto sulla protezione dei dati prevista dal regolamento generale in presenza di trattamenti ad alto rischio. La seconda misura probabilità e gravità del rischio per i diritti e le libertà rispetto al trattamento; la prima interroga il contenuto culturale del dataset, cioè categorie, linguaggio e assunzioni implicite. Un ente può aver completato correttamente la valutazione d’impatto privacy e conservare intatto un problema di rappresentatività. Le Raccomandazioni suggeriscono di integrare valutazioni costruite sul modello dell’AI Act, con analisi preventive e periodiche attente ai diritti fondamentali, ai bias, all’accessibilità e all’intersezionalità. Due istruttorie che condividono documenti e interlocutori e rispondono a domande diverse, entrambe da portare a un tavolo unico per evitare duplicazioni.
La quarta raccomandazione chiude il blocco con la governance del ciclo di vita, in particolare per i dati personali e sensibili. Chiede una gestione improntata a minimizzazione, controllo, apertura e protezione fin dalla progettazione; il privilegio, ove possibile, di forme di elaborazione locale sui dispositivi, così da ridurre la circolazione dei dati personali; la documentazione chiara di quali dati vengono salvati, per quali finalità e per quanto tempo, con anonimizzazione e cancellazione applicate by design; l’apertura dei dati come forma di gestione trasparente, proporzionata e controllabile.
L’indicazione sull’elaborazione locale tocca una scelta architetturale che molte amministrazioni compiono senza esserne consapevoli. Quando un ufficio adotta un assistente conversazionale in versione cloud per redigere testi, sta decidendo che i contenuti trattati attraversano infrastrutture esterne. La stessa attività svolta con un modello eseguito localmente produce un profilo di rischio diverso a parità di risultato. La scelta appartiene all’amministrazione, e per compierla in modo informato serve qualcuno che sappia porre la domanda nel momento giusto, cioè prima della firma del contratto. Presidiare la catena di custodia, tenere il registro delle valutazioni etico-sociali, sedere al tavolo con il responsabile della protezione dei dati e con il Comitato Unico di Garanzia: attività che oggi si distribuiscono per frammenti fra chi ha tempo, e che accorpate in una responsabilità riconoscibile riducono la probabilità di scoprire un problema quando il sistema è già in esercizio.
Fonti di questa puntata
Raccomandazioni della Community italiana per il governo aperto sull’utilizzo dell’Intelligenza Artificiale, luglio 2026, licenza CC-BY 4.0.
Italia Open Gov, «Intelligenza Artificiale nella PA: le Raccomandazioni elaborate dalla Community italiana per il governo aperto», 31 luglio 2026: https://open.gov.it/notizie/intelligenza-artificiale-pa-raccomandazioni
6° Piano d’Azione Nazionale per il governo aperto 2024-2026, obiettivo B, impegno 5: https://open.gov.it/governo-aperto/piano-nazionale/6nap/azione-2/impegno-5
Regolamento (UE) 2024/1689 sull’intelligenza artificiale, articoli 4 e 50: https://eur-lex.europa.eu/eli/reg/2024/1689/oj
Associazione Italiana della Comunicazione Pubblica e Istituzionale, presentazione delle Raccomandazioni: https://www.linkedin.com/posts/associazione-italiana-della-comunicazione-pubblica-e-istituzionale_raccomandazioni-per-il-governo-aperto-della-activity-7489206216120840193-uF7E
⬇️ Scarica le Raccomandazioni: https://open.gov.it/notizie/intelligenza-artificiale-pa-raccomandazioni
Newsletter LinkedIn: https://www.linkedin.com/newsletters/ai-officer-newsletter-7402362836275875841/
Martin Enrico Iglesias, giornalista professionista ODG Lombardia, comunicatore pubblico, iscritto all’Associazione Italiana della Comunicazione Pubblica e Istituzionale.